来到北京第一天,参加大语言模型的实践。
今天北京真的是格外的冷,零下19度,还有大风呼呼的吹,本来带了两件外套想着轮着穿,结果到最后一起穿在了身上,裹的和太空人一样
课程资源介绍
我们的课程资源大概有这三个方面:
-
《Hands-On Large Language Models》
这书倒是蛮新的,新到国内尚无中文译本(截至我们开课前2025.2.7)
而且手把手教着搓大语言模型,实践性很强,有配套的Github代码仓库
texthttps://github.com/rasbt/LLMs-from-scratch -
《大语言模型》(赵鑫/李军毅/周昆/唐天一/文继荣 著)
这书感觉就是更加理论化一点,而且因为是国内大佬编写的,所以也不像第一个英文原版一样读起来还有点困难,作为实践之中的理论补充还是非常不错的
-
OpenBMB
这是个携手清华打造的线上课程,分p很细,可以挑选自己感兴趣的着重学习一下,虽然这个主要是我们在实践前作为前置内容学习的,不过课程还是非常有质量有深度的,回来还是要再好好看一下
ok,那么接下来就要进入课程了
一开课的惯例:课程介绍,老师介绍,大语言模型趋势,人工智能与机器学习的基本概念介绍
一大堆介绍完之后,终于来到了大语言模型的简介。这也算是我最感兴趣的内容,从了解到大语言模型之日起(大概是在22年11月份刚刚使用过GPT后不久),我就一直非常好奇这种LLM究竟是怎样理解我们人类的语言的,之前只是模模糊糊知道一点关于”token”的事情,知道那是个大概的大模型拆分语言的单元,今天总算能从头到尾去彻底理解一下了
(另外下面小小的感慨一下)
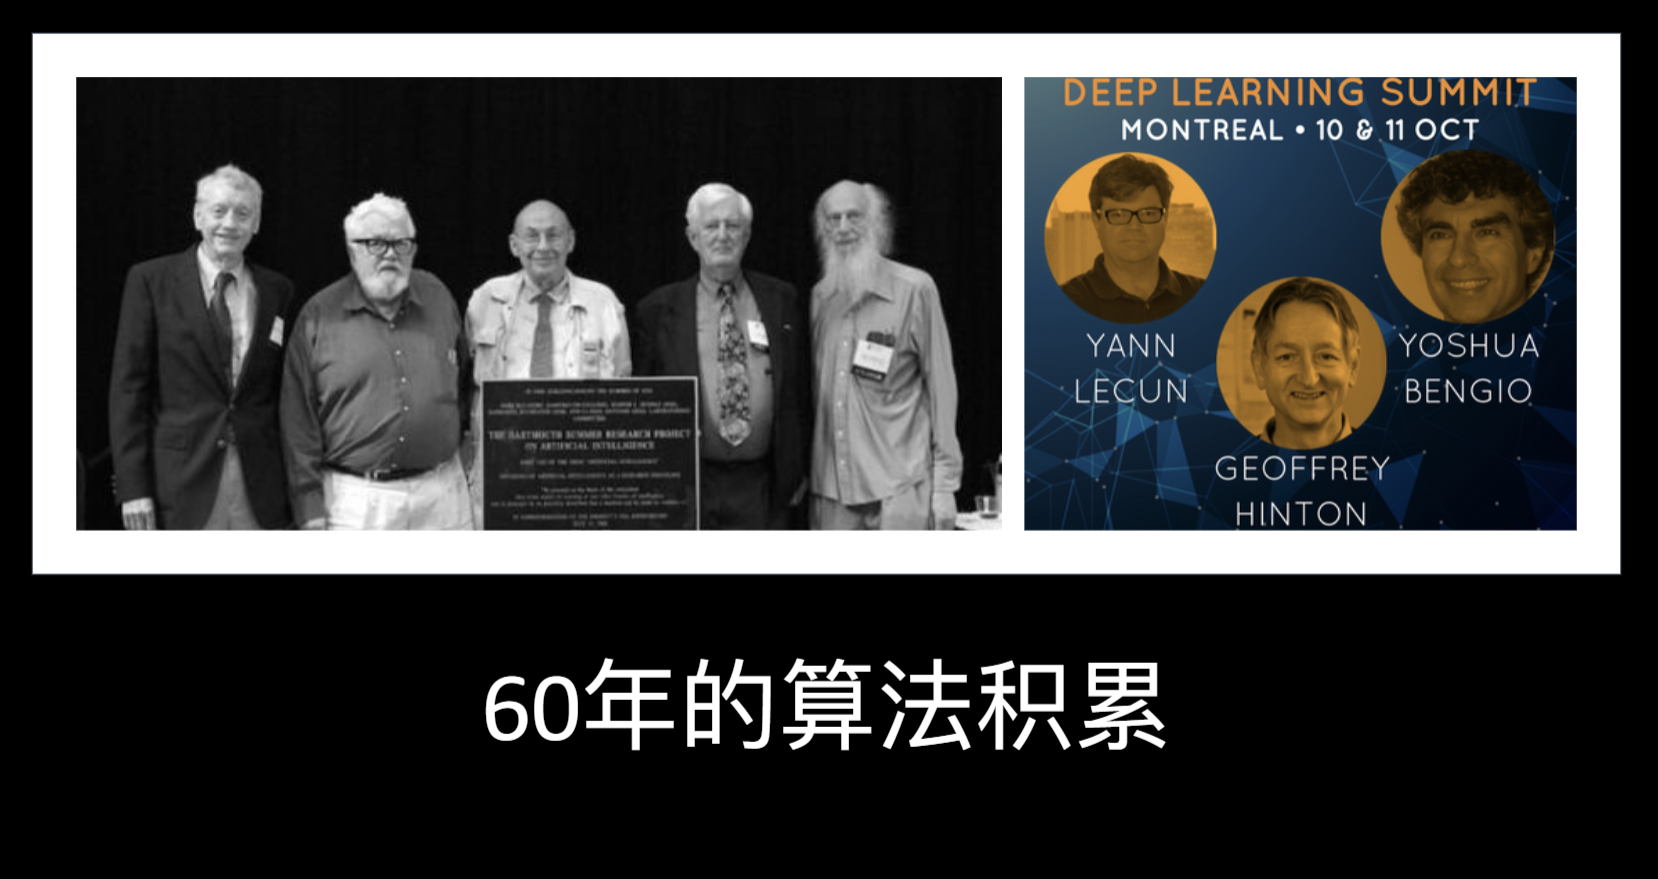
PPT正文首页就是”60年的算法积累,辛顿位列C位,能在60年前人类的CPU才刚刚买入集成电路的时代的算力条件下有勇气去搞神经网络,”先驱”一词在他身上大概就是最好的体现。 (另外,对于辛顿有一篇文章写的特别好,可以来看看 为什么有些人能够那么强大又那么温柔? - 知乎)
好了言归正传,让我们首先来从大语言模型的历史开始:
自然语言处理引子
在2017年划时代的Transformer架构发布之前,众多优秀的计算机科学家也在自然语言处理的道路上进行了深远的探索。
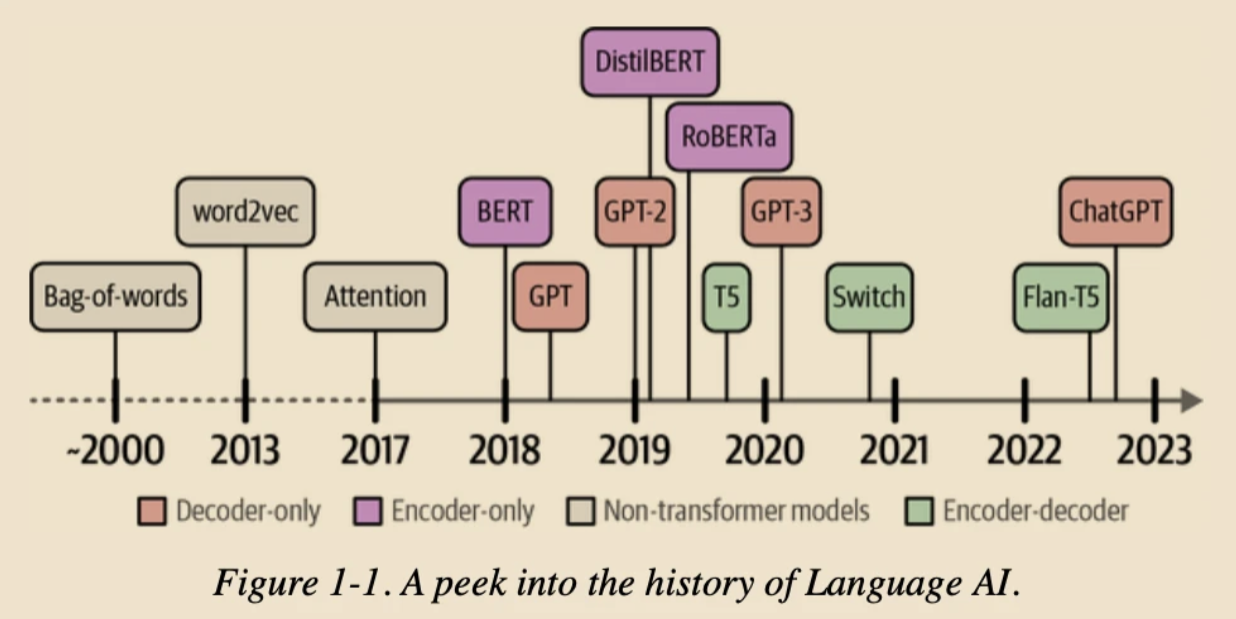
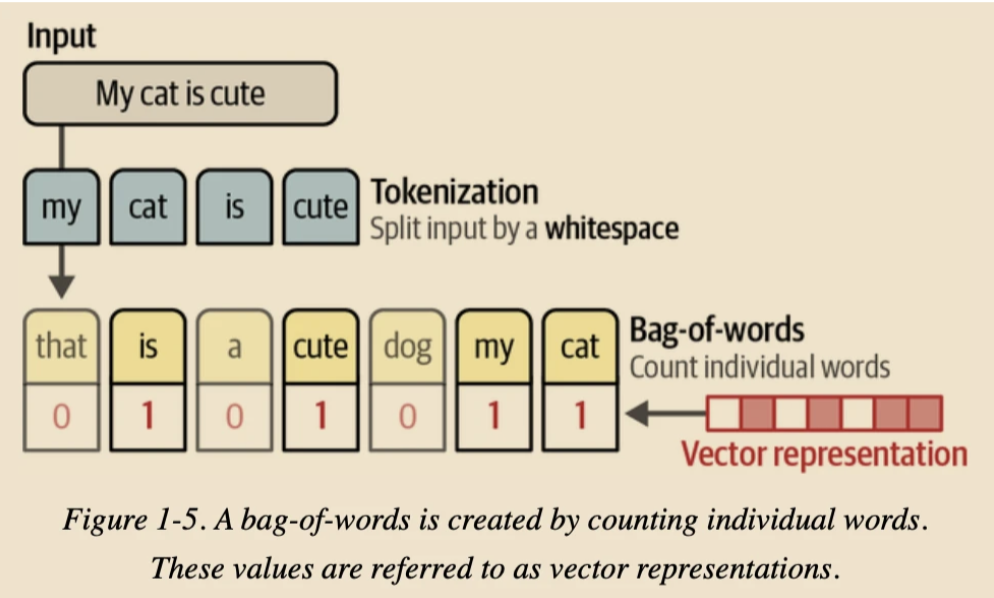
1. 词袋模型 (Bag-of-Words)
主要前提:
假设文本的语义主要由其中包含的词汇及其出现次数决定,而词的顺序和语法可以忽略。
构建过程:
- 首先需要从训练文本中提取所有不同的单词,形成一个词典
再对于每一文本,根据词典中单词的出现次数,将文本转换为一个向量
-
有点抽象不太好懂?
举个例子:
假设有两句话:”我爱自然语言处理”和”自然语言处理很有趣”。
构建词典时,会将所有不同的词列出:[“我”, “爱”, “自然语言处理”, “很”, “有趣”]。
第一句话对应的向量就是1,1,1,0,0,第二句话对应的向量是0,0,1,1,1。
词袋模型的处理就是这个样子,有点类似于关键词匹配
评价:
这样子好处当然是有的,处理算法的简单带来了计算的高效
但是缺点也显而易见:
- 丢失语序信息:词袋模型忽略了词的顺序,这可能导致对文本语义的误解,比如 “我喜欢她”和”她喜欢我”在词袋模型中表示相同,但这实际上就根本不是一回事
- 维度灾难: 当文本数据量大时,词典的维度可能会变得非常高,导致向量维度过大,增加计算复杂度。
- 无法捕捉语义:无法捕捉词之间的语义关系和上下文信息,不同的词即使语义相似,在词袋模型中也会被表示为不同的维度。
2.Word2Vec (稠密向量/嵌入向量)
这我觉得是一项天才般的技术设计,巧妙地使程序具有了类似人类的语义理解功能,让我们一起来看一下:
-
主要假设:
分布式语义假说(”You shall know a word by the company it keeps”)
也就是说,它信奉词的出现上下文决定词的语义假说,将每个词看成一个点,通过训练,让频繁一起出现的词在向量空间中距离更近,从而捕捉词的语义信息。
-
我们举一个二维空间的例子来理解:
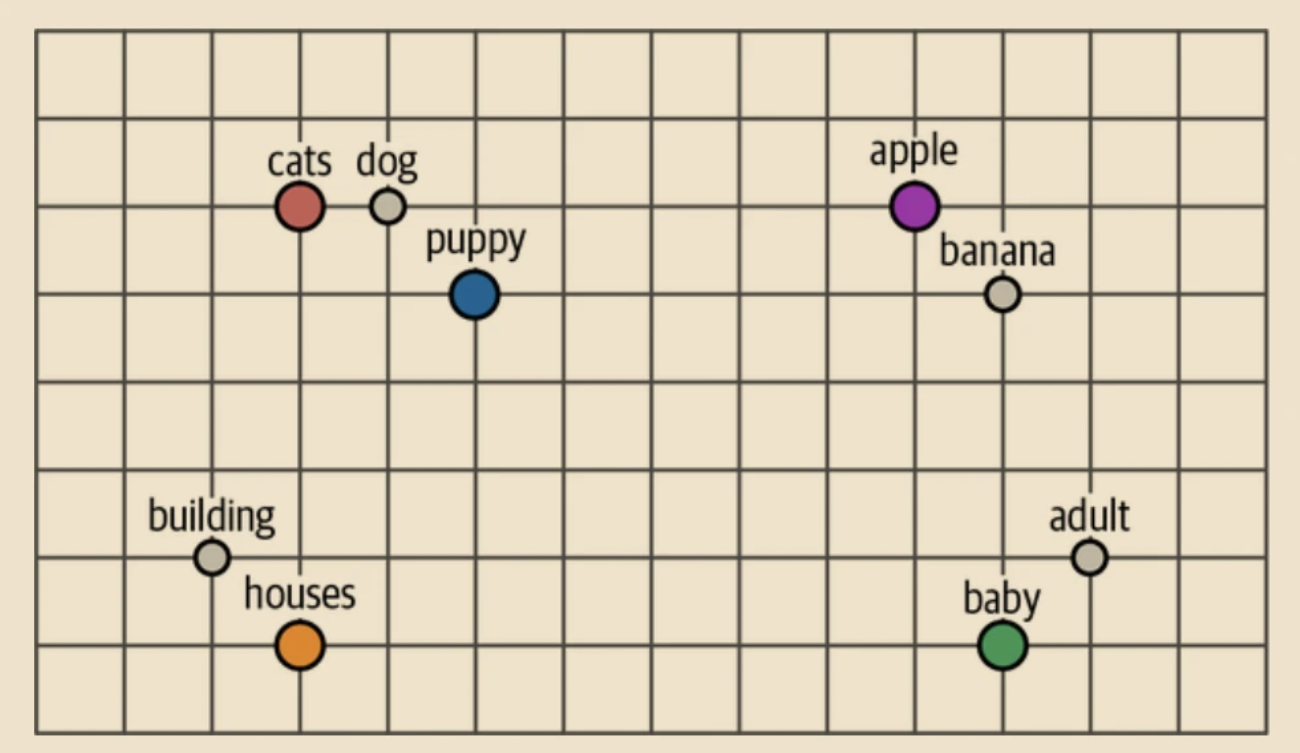
如图所示我们可以看到有cats dog apple building adult等单词分布在这个空间中 其中 cats dog puppy都是小宠物一类的,在这个向量空间中就非常接近,聚成了一簇;同时我们观察另外几个类似的簇,都能找到类似的共同点
那么,通过查找在向量空间中的距离远近,大语言模型就可以理解其中不同词的相关性,做出一种语义的理解。
-
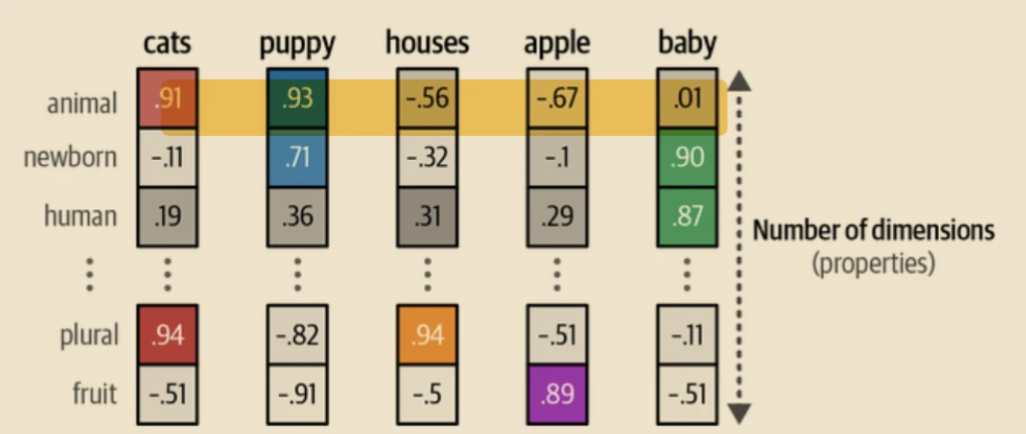
想想看,我们人类的词典也是用一些词去解释另一个词,直到一些基本的词不能再拆分为显式的解释,而是一种模模糊糊的次级概念。对于大模型也是一样word2vec技术也并没有具体的把每个簇都显式地加上一个标签对吧,也是大模型的一种模模糊糊的次级概念理解。
-
那么在自然语言的处理过程中,将语言中的词去映射为低维,稠密的向量的过程,就叫做向量嵌入,也就是常说的embedding过程。
-
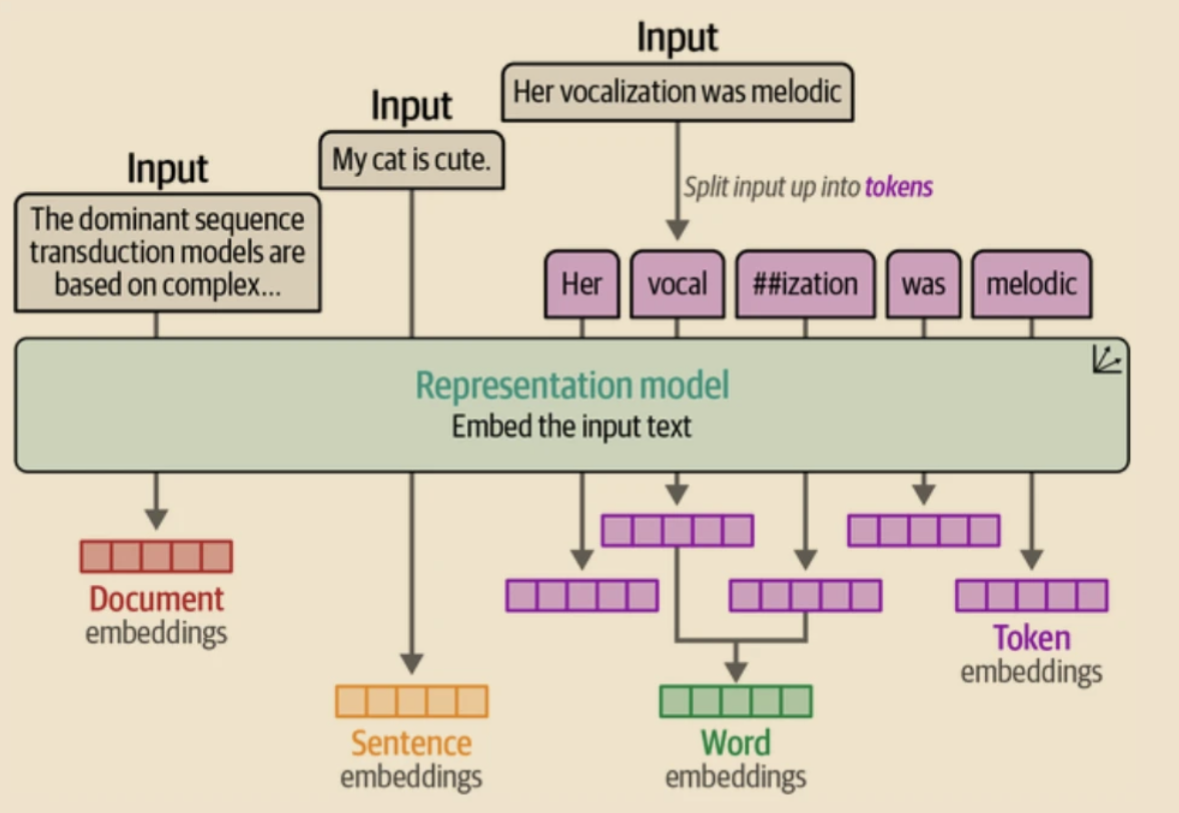
而且不仅是单词,实际上,不同层级的文本都可以做embedding,token层级,word层级,sentence层级,document层级上都可以做向量嵌入,单词的embedding就是单词的一个向量表示它的语义,句子的embedding就是这句话的语义向量(当然可能这句话的语义很复杂,但确实是可以的),文档的embedding就是这一大段的一个整体的语义。
-
缺点:
- 一词多义问题: 像是charge这样有很多很不想干的释义就难以在向量空间中找到合适的对应位置
- 缺少上下文信息:如像是it这种代词,单论语义很复杂,什么都有可能包含,需要去看上下文信息解读所代指的东西,但如果纯靠向量来解析语义就很困难
3. RNN(Recurrent Neural Network)
那么为了解决上下文信息的问题,人们又引入了这玩意——循环神经网络
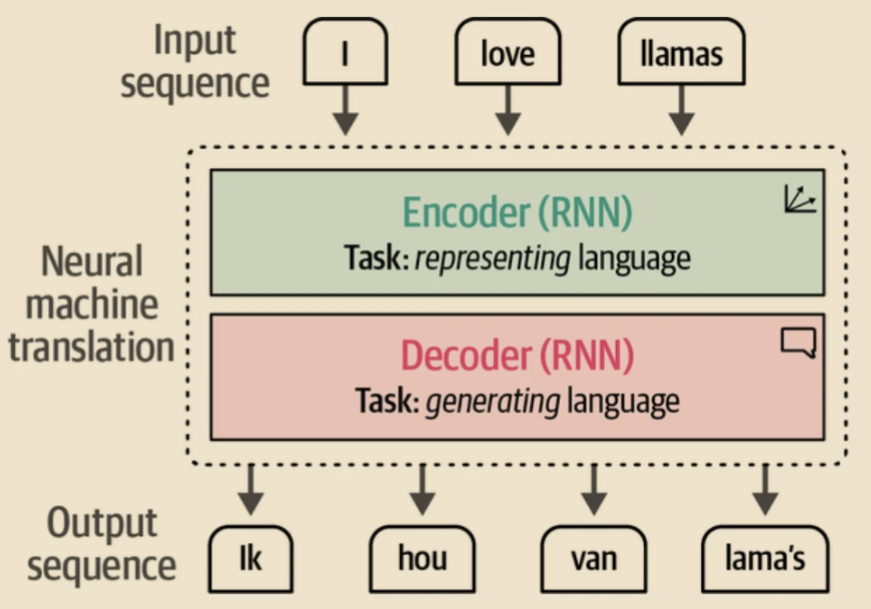
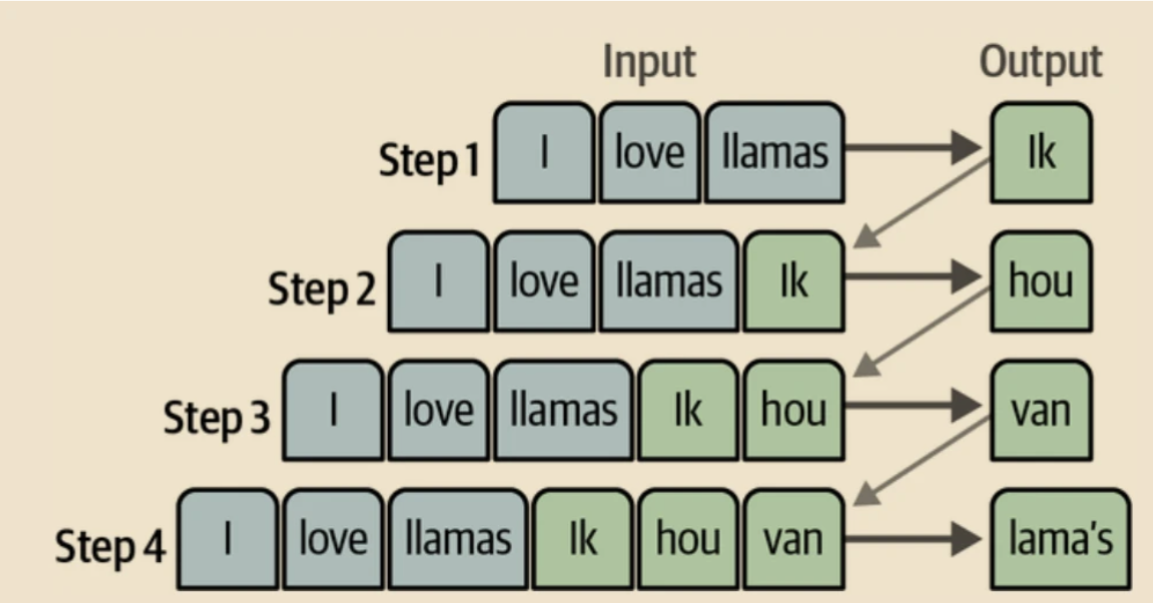
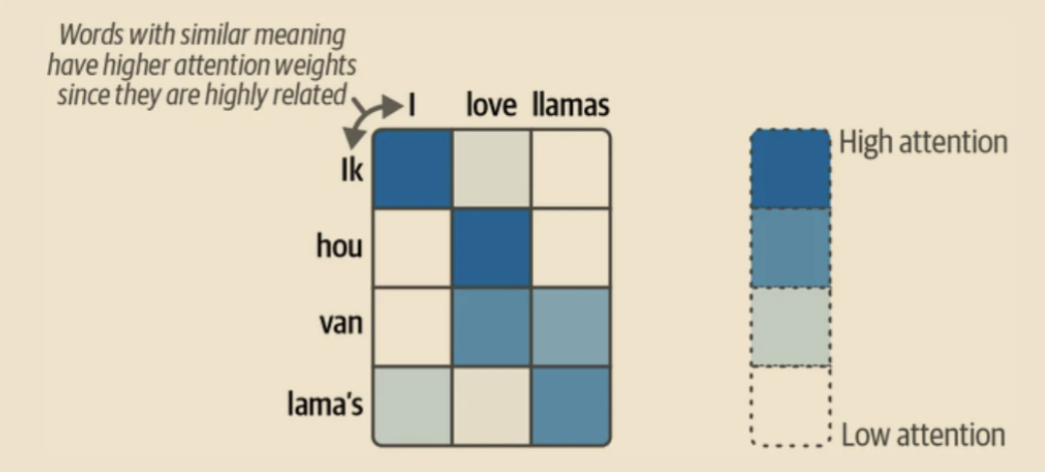
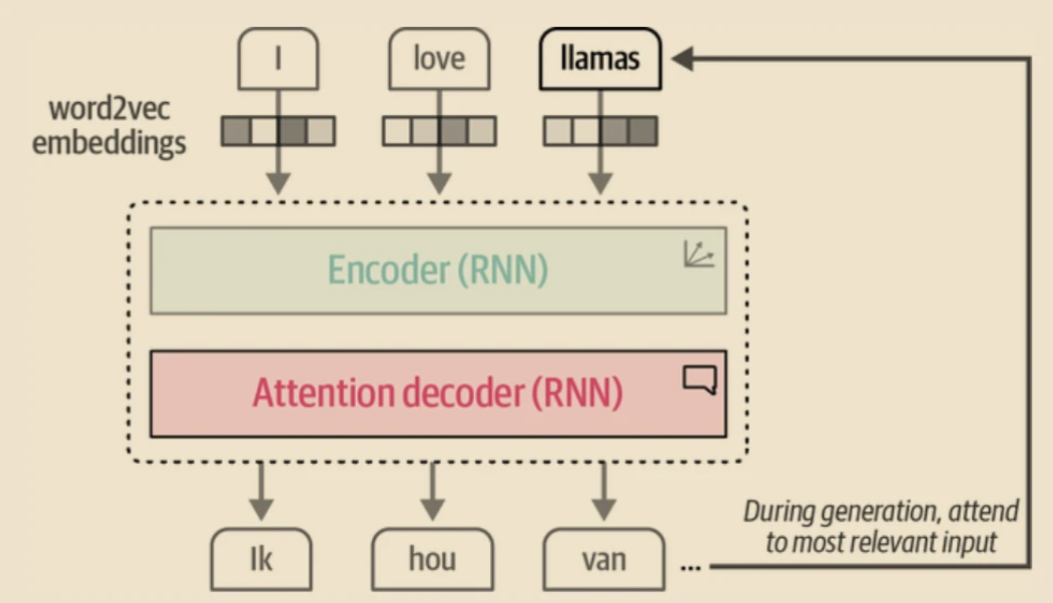
- RNN 具有记忆功能,它会对之前的信息进行记忆,将信息从当前步骤传递到下一步骤,形成一个循环结构,使得网络能够记住之前的信息,对于序列数据的处理非常有效。
-
(该图展示的为带注意力机制的RNN)
-
但是我们从他的运行方式就可以看到,它是一种循环顺序运行的方式,每次只处理一个附加的token,这种方式无法并行计算,就无法使其运行速度得到很大的提高。
而且这种序列化的处理方式也对训练带来了很多困难。如果训练的序列过长,就会有梯度消失或者梯度爆炸,难以捕捉长序列中的上下文关系。
尾声
好了,Bag-of-Words带我们迈入了自然语言处理的大门,Word2Vec技术又通过巧妙的向量语义空间设置,使自然语言处理在语义理解方面甩开了大步子,RNN试图解决上下文的注意力问题,但方向似乎有点不对头,无法并行计算到最后终究只能靠大力出奇迹,但也走得很远了,在一般的情感分析和机器翻译任务中也取得了不少傲人的成绩。
一切都已就位,但似乎就差那么关键的一步了……
RNN的无法并行计算特点极大地限制了算力的释放,针对上下文的处理也并没有达到很好的效果,这成为了卡住大规模自然语言处理的最后一道枷锁。
舞台已经搭建完毕,演员也已全部就位,那划时代的架构也该登场了……
评论
Discussion · 0登录后参与讨论 · Sign in to join the discussion
用 GitHub 账号登录,就可以评论、回复和点赞。
使用 GitHub 登录还没有评论 · 来写下第一条吧。